
읽기 순서
나뉜 지면을, 이어지는 문맥으로
제목과 본문, 보조 설명을 구분해 읽는 순서와 내용의 연결 관계를 정리합니다.
DOCUMENT STRUCTURE
문서의 의미는 텍스트만으로 결정되지 않습니다. 제목과 본문의 관계, 표의 행과 열, 조항에 붙은 예외 조건까지 함께 읽어야 합니다. 문서 요소를 구분하고 서로의 관계를 연결해, 추출과 검색에 필요한 맥락을 보존합니다.
읽기 순서
제목과 본문, 보조 설명을 구분해 읽는 순서와 내용의 연결 관계를 정리합니다.
표 구조
셀의 값을 행과 열의 제목에 연결해, 수량과 단가 등 각 값의 의미를 유지합니다.
조항 구조
상위 조항과 하위 항목을 연결하고, 조건과 예외를 함께 정리해 문맥을 보존합니다.
도식과 관계
흐름도의 단계와 분기 조건을 읽어, 진행 순서와 조건별 경로를 정리합니다.
SCHEMA-BASED EXTRACTION
업무에 필요한 항목과 출력 기준에 맞춰 날짜와 금액, 반복 내역을 정리합니다. 없거나 불확실한 값은 상태와 사유를 함께 남깁니다.
날짜 표기와 금액의 숫자, 통화를 시스템에서 사용할 형식으로 통일합니다.
같은 행의 품목명과 수량, 단가, 금액을 묶어 항목 간 관계를 유지한 목록으로 정리합니다.
원문에 없는 값과 추가 확인이 필요한 값을 구분하고, 상태와 사유를 남깁니다.
EVIDENCE & VALIDATION
추출 결과에는 값뿐 아니라 확인할 근거가 필요합니다. 원본 위치를 연결하고 필수 항목, 데이터 형식, 값 사이의 일관성을 검토합니다. 기준을 충족한 결과와 추가 확인이 필요한 결과를 구분해, 담당자가 무엇을 왜 검토해야 하는지 알 수 있도록 합니다.
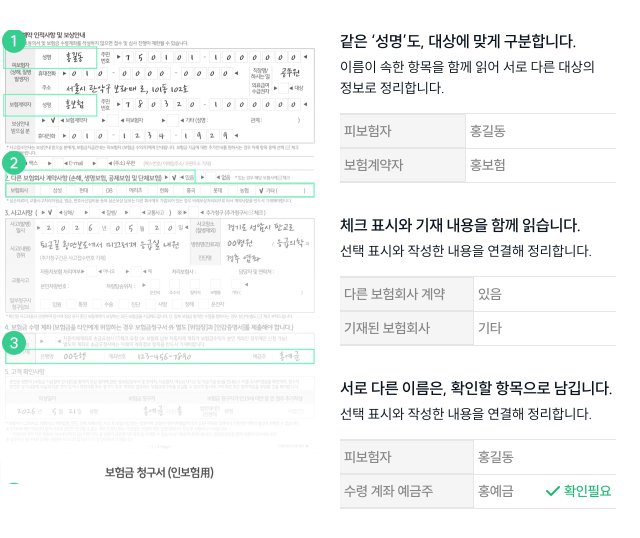
이름이 속한 항목을 함께 읽어 서로 다른 대상의 정보로 정리합니다.
선택 표시와 작성한 내용을 연결해 정리합니다.
선택 표시와 작성한 내용을 연결해 정리합니다.
필수 항목이 채워졌는지, 날짜와 금액이 정해진 형식인지, 관련 값들이 서로 일치하는지 확인합니다. 예를 들어 공급가액과 부가세의 합이 합계 금액과 맞는지 검토할 수 있습니다.
사전에 정한 검증 기준을 충족한 결과를 다음 업무로 전달합니다. 근거가 연결되었다는 사실만으로 결과를 확정하지 않고, 해당 업무의 처리 기준을 별도로 적용합니다.
판독이 어려운 값, 항목 간 불일치, 별도 문서 확인이 필요한 조건을 검토 대상으로 구분합니다. 담당자는 추출값과 원본, 검토 사유를 함께 보고 확인할 수 있습니다.
PROCESSING & INTEGRATION
문서 종류와 필요한 결과에 맞춰 수신, 분석, 추출, 검증, 전달 단계를 구성합니다. 각 단계의 결과와 처리 상태를 연결해, 문서를 읽는 작업이 시스템 입력이나 담당자 검토로 이어지도록 설계합니다.
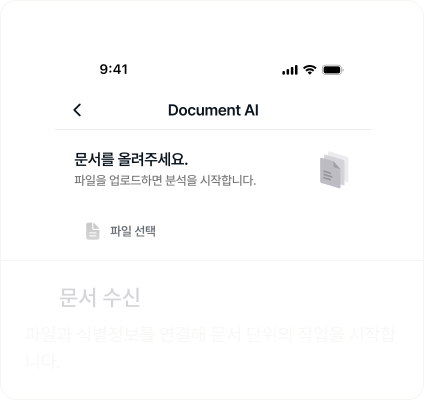
파일과 식별정보를 연결해 문서 단위의 작업을 시작합니다.
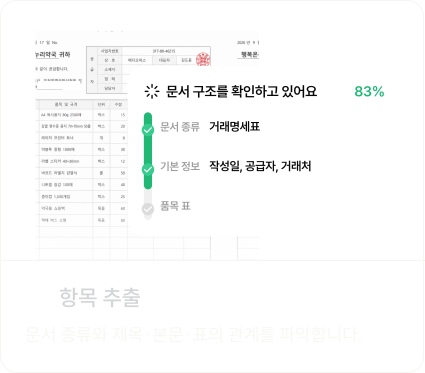
문서 종류와 제목·본문·표의 관계를 파악합니다.
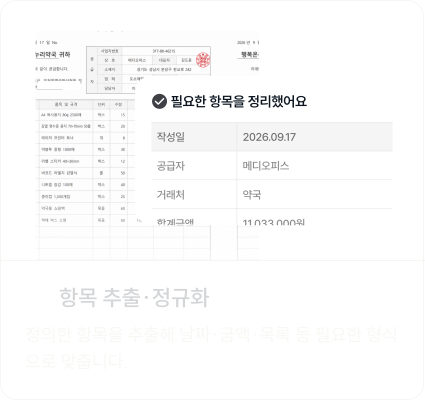
정의한 항목을 추출해 날짜·금액·목록 등 필요한 형식으로 맞춥니다.
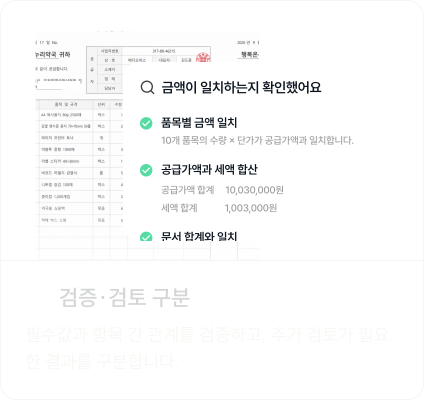
필수값과 항목 간 관계를 검증하고, 추가 검토가 필요한 결과를 구분합니다.
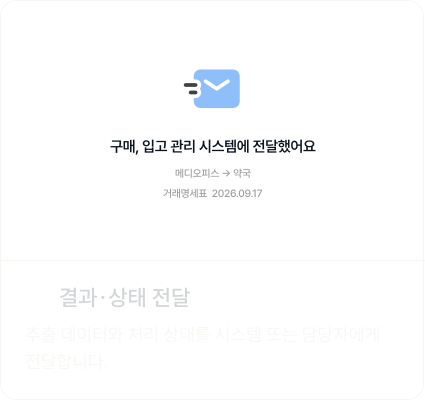
추출 데이터와 처리 상태를 시스템 또는 담당자에게 전달합니다.
날짜와 금액, 대상자, 반복 내역을 정해진 항목으로 정리해 시스템 입력과 후속 처리에 활용합니다.
제목과 본문, 표에 원본 위치를 연결해 검색과 답변 과정에서 문맥과 근거를 확인할 수 있도록 합니다.
DOCUMENTS & EVALUATION
같은 종류의 문서도 양식과 촬영 상태, 표기 방식에 따라 결과가 달라집니다. 대표 문서와 예외 사례를 함께 평가해 안정적으로 처리할 범위와 사람의 검토가 필요한 지점을 확인합니다.
헬스케어 분야 전문서류
약품명과 검사 수치를 정확히 읽고, 복용 정보와 반복 내역을 올바르게 연결하는지 확인합니다. 판독이 어려운 항목도 검토 대상으로 구분되는지 살펴봅니다.
청구 서류
진단서와 진료비 영수증에서 필요한 항목을 추출하고, 문서 간 정보를 대조합니다. 필수값의 누락과 불일치를 찾아내는지 확인합니다.
문서별 평가 결과를 바탕으로 정확도와 검토 비율, 처리시간과 예외 유형을 함께 확인합니다.
날짜와 금액, 식별정보 등 주요 항목을 정답과 대조해 오류를 확인합니다.
사람의 확인이 필요한 비중과 사유를 살펴, 실제로 남는 검토 부담을 평가합니다.
문서 분량과 품질, 실행 환경을 고려해 측정합니다. 자동 처리시간과 담당자 검토를 포함한 전체 소요시간을 구분합니다.
누락과 오류가 반복되는 조건을 분석해 추출 기준과 검토 절차, 적용 범위를 조정합니다.